
Długie rozmowy techniczne w ChatGPT: pierwsze obserwacje
Przy pracy nad Anima Engine używamy rozmów AI inaczej niż w krótkich sesjach pytanie-odpowiedź. Jedna rozmowa potrafi przez wiele dni obsługiwać audyty, decyzje architektoniczne, dokumenty, raporty i wyniki narzędzi.
Punkt wyjścia
Niektóre rozmowy techniczne stają się bardzo długimi przestrzeniami roboczymi. Zawierają kolejne etapy pracy, duże fragmenty dokumentów, wyniki narzędzi, bloki kodu, reasoning, podsumowania i decyzje projektowe. W takim trybie sama rozmowa zaczyna być elementem infrastruktury pracy, a nie tylko krótkim kanałem komunikacji.
Co zauważyliśmy
Część bardzo długich rozmów zaczęła okresowo wykazywać znaczący spadek wydajności interfejsu. Objawy obejmowały długie otwieranie rozmowy, opóźnienia podczas przewijania, chwilową utratę responsywności edytora wiadomości, problemy z renderowaniem dużej historii oraz okresowe trudności przy przełączaniu pomiędzy rozmowami.
Zachowanie nie było stałe
Najciekawsze jest to, że problem nie występował zawsze tak samo. Ta sama rozmowa mogła przez pewien czas działać bardzo źle, a później bez zmian po stronie lokalnego komputera ponownie działać płynnie. To osłabia proste wyjaśnienie, że rozmowa po prostu osiągnęła maksymalny rozmiar.
Co udało się zmierzyć
Dla jednej z problematycznych rozmów zapisaliśmy HAR oraz trace wydajności. Historia pobierana przez aplikację miała około 6,98 MB i zawierała około 1292 elementów drzewa rozmowy. Wśród nich były odpowiedzi asystenta, wywołania narzędzi, bloki kodu, wyniki wykonania, reasoning i podsumowania.
Koszt renderowania interfejsu
Sam request historii zakończył się poprawnie. Bardziej interesujące było to, co działo się później po stronie przeglądarki. Telemetria pokazała wielosekundowe blokowanie głównego wątku JavaScript oraz kosztowne operacje layoutu. W jednym z przypadków pojedynczy etap layoutu trwał ponad 10 sekund, a w osobnym pomiarze długa klatka renderowania przekroczyła 13 sekund.
Ciekawy przypadek gałęzi rozmów
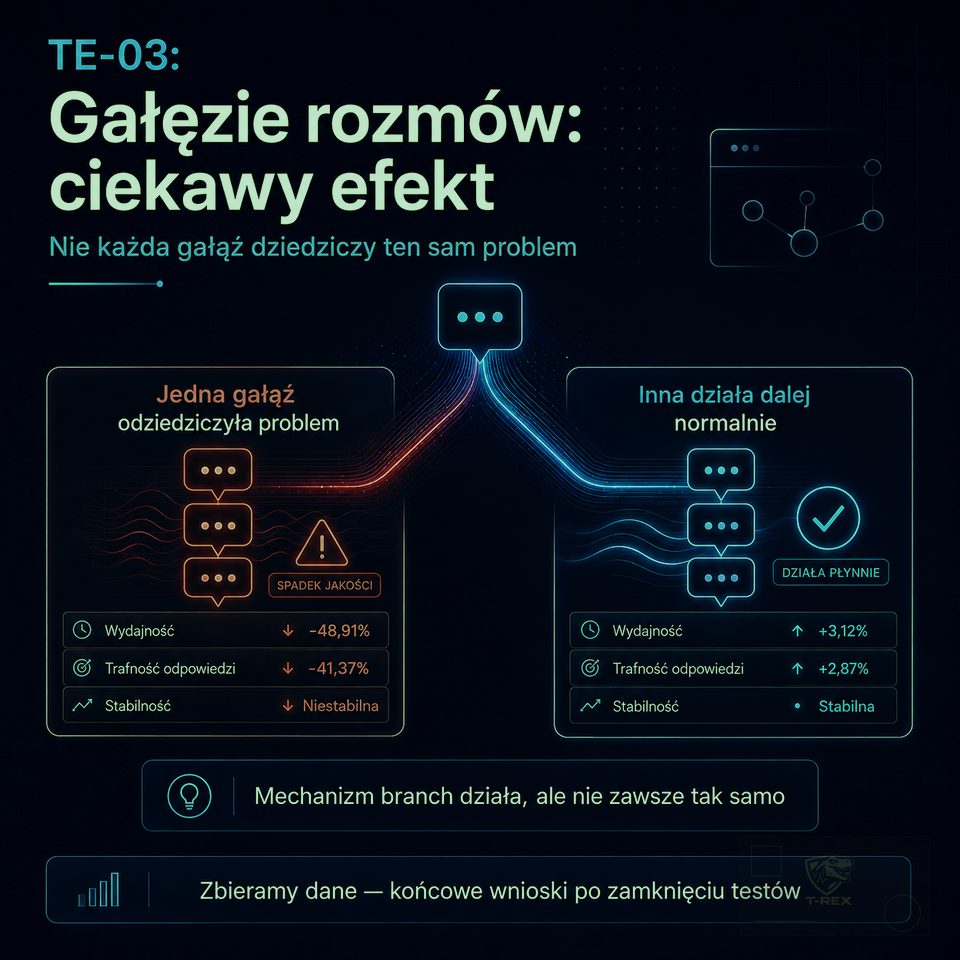
Testujemy także mechanizm tworzenia nowych gałęzi rozmowy. Wynik nie jest jednoznaczny. Jedna gałąź szybko zaczęła zachowywać się podobnie jak problematyczna rozmowa źródłowa. Inna gałąź, również intensywnie wykorzystywana do pracy technicznej, nadal działa poprawnie i pozwala prowadzić kolejne audyty oraz wieloetapowy workflow.
Czego na razie nie twierdzimy
Na obecnym etapie nie mamy podstaw, żeby jednoznacznie wskazać maksymalny kontekst modelu, liczbę wiadomości, wiek rozmowy, mechanizm Branch, liczbę bloków narzędziowych, konkretną wersję modelu albo obciążenie infrastruktury jako jedyną przyczynę. Każdy z tych czynników może mieć znaczenie, ale teraz byłoby to tylko założenie.
Co dalej
Będziemy porównywać kolejne długie rozmowy, rozmowy główne i ich gałęzie, wielkość pobieranej historii, liczbę elementów narzędziowych, czas renderowania, zachowanie interfejsu w różnych momentach oraz przypadki, w których problem pojawia się i później sam znika.
Wniosek
Test nadal trwa. Po zebraniu większej liczby przypadków chcemy rozdzielić trzy rzeczy, które łatwo ze sobą pomylić: limit kontekstu modelu, zarządzanie historią rozmowy oraz koszt renderowania interfejsu.