
TE-01: optymalizacja kontekstu i zużycia tokenów
W Anima Engine mierzymy nie tylko to, czy model wykonał zadanie poprawnie. Coraz ważniejsze staje się również to, ile kontekstu, tokenów i czasu potrzeba, żeby doprowadzić system do poprawnego wyniku.
Punkt wyjścia
W systemach opartych na LLM łatwo przyjąć założenie, że im więcej kontekstu otrzyma model, tym większa będzie szansa na poprawną odpowiedź. Przy małych zadaniach często nie ma to dużego znaczenia. Problem pojawia się wtedy, gdy system zaczyna pracować na wielu dokumentach, zasadach, historii decyzji, raportach i danych technicznych.
Kontekst jako koszt architektoniczny
W dużych procesach agentowych koszt LLM nie wynika wyłącznie z ceny modelu. Może wynikać także z tego, że ten sam duży zestaw informacji jest wielokrotnie przekazywany do kolejnych etapów procesu, mimo że większość tych danych nie jest w danym momencie potrzebna. Wtedy koszt kontekstu zaczyna być realnym elementem architektury.
Czym był test TE-01
W teście TE-01 sprawdzaliśmy mechanizm przygotowujący dla modelu ograniczony zestaw informacji potrzebnych do wykonania konkretnego zadania. Nie chodziło o proste skracanie promptu. Celem było zachowanie informacji wymaganych do poprawnego wykonania zadania przy jednoczesnym usunięciu danych, które dla danego przebiegu nie były potrzebne.
Pierwszy pomiar
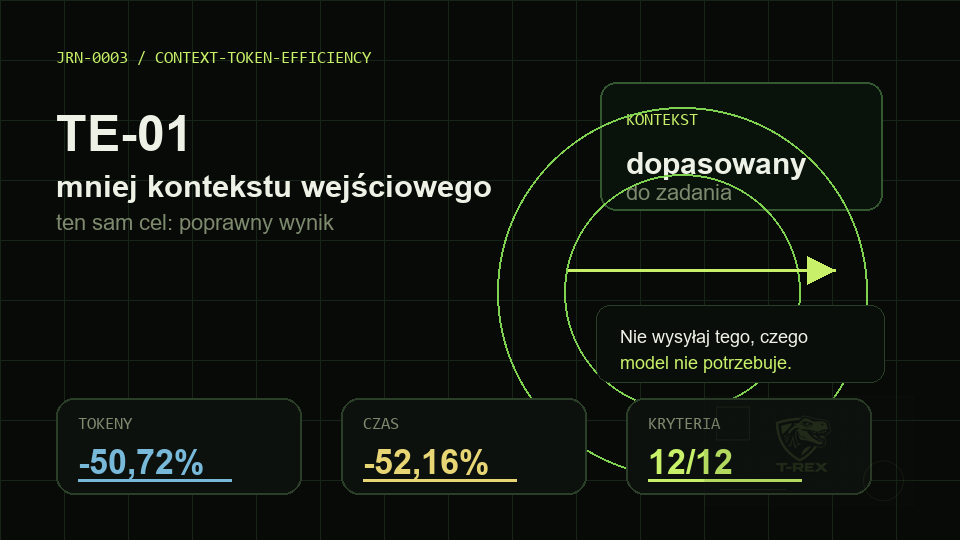
W pierwszym kontrolowanym przebiegu uzyskaliśmy 50,72% mniejsze zużycie tokenów, 52,16% krótszy czas wykonania, 12/12 spełnionych kryteriów akceptacyjnych oraz brak wykrytej regresji w badanym przebiegu. Najciekawsza była korelacja pomiędzy redukcją tokenów i czasu wykonania.
Jak interpretujemy wynik
Spadek czasu o około 52% przy redukcji wejścia o około 51% sugeruje, że w tym konkretnym przypadku koszt obsługi dodatkowego kontekstu był istotną częścią całego przebiegu. Nie oznacza to jednak, że redukcja kontekstu zawsze będzie dawała liniową redukcję czasu. Wynik zależy między innymi od modelu, rodzaju zadania, liczby wywołań, cache, narzędzi oraz sposobu orkiestracji.
Zasada praktyczna
Jednym z kierunków optymalizacji Anima Engine jest traktowanie kontekstu jako zasobu, którym trzeba zarządzać podobnie jak pamięcią, czasem CPU albo liczbą operacji wejścia i wyjścia. Model powinien dostać wystarczający kontekst, ale niekoniecznie cały dostępny kontekst. To istotna różnica.
Czego ten test jeszcze nie dowodzi
TE-01 nie traktujemy jako zakończonego dowodu, że można obniżyć koszt AI o połowę. To był pierwszy pomiar konkretnego mechanizmu w określonych warunkach. Przed nami są kolejne przebiegi A/B, sprawdzenie powtarzalności wyniku, analiza przypadków pogorszenia jakości, pomiar wpływu na różne klasy zadań oraz określenie bezpiecznej granicy redukcji.
Status
Eksperyment trwa. Kolejne testy mają pokazać, jak mierzyć koszt kontekstu, jak porównywać warianty i czy pierwszy wynik TE-01 utrzyma się przy następnych przebiegach.
Wniosek
Pierwszy wynik TE-01 jest obiecujący, ale najważniejsza lekcja jest bardziej podstawowa: w systemach LLM kontekst nie jest darmowym tłem. To zasób, który trzeba dobierać świadomie.